
主题
10.2 本地模型(Ollama)部署与使用
想完全离线、代码数据不出本机、有显卡/内存想零成本复用本机算力——用 Ollama 把开源代码模型跑在本机,免费、隐私。
返回总览:10.1 AI 编程助手 | 另一方式:10.3 云端大模型使用 | 什么都不想装:10.10 用免费的大模型网页问
一、适用场景与准备
适合谁:
- 想完全离线(断网也能用)
- 数据/代码不能出本机(涉密、隐私)
- 机器至少有 8GB 内存(7B 模型);有独显更佳
- 不愿折腾 API Key、付费
需要什么:
- Windows 10/11,能装软件
- 内存 ≥ 8GB(推荐 16GB+);磁盘空 10GB+(模型 4~8GB)
- 能装 Ollama + 拉一个代码模型(推荐
qwen2.5-coder:7b) - 模型上下文窗口 ≥ 32K(硬性要求,低于此值会静默出错,见 第三节)
两种模型路径怎么选,先看这张对比:
二、安装 Ollama
- 访问 https://ollama.com/download,选 Windows,下载
OllamaSetup.exe双击安装。 - 装完会在系统托盘出现一个羊驼图标,并默认监听
http://127.0.0.1:11434。 - 打开 PowerShell 验证:
powershell
ollama --version
# 能输出版本号即安装成功
Ollama 必须一直在后台
没启动就发消息会连不上。看一眼系统托盘的羊驼图标在不在,或 ollama list 能列出模型即代表服务在线。
三、拉取一个代码模型
推荐 qwen2.5-coder:7b(阿里通义千问代码模型,7B 约 4.7GB,效果与体量平衡);机器弱用 qwen2.5-coder:3b,显存大可上 codellama:7b / deepseek-coder:6.7b。
powershell
ollama pull qwen2.5-coder:7b     # 拉取(首次需联网下载,耐心等进度条)
ollama list                      # 查看已安装的模型
模型上下文窗口必须 ≥ 32K(低于此值会静默出错)
AI 助手每次提问,都会把一份知识包连同您的问题一起发给模型——里面包含您这台设备 支持哪些 Lua 库、高频 API 的正确写法、易错点反例、以及点位地址范围,约 1.6 万字符。
- 上下文 ≥ 32K:正常,模型能完整读到这份知识包。
- 上下文 < 32K(如默认 4K / 8K / 16K 的小模型):知识包会被从开头截断, 模型看不到「输出格式要求」和「禁止的写法」,表现为回复为空、答非所问、 或自己编出不存在的函数。
这类失败是静默的——它不会报错,只会给出一份看着像样但错误的代码, 直接插进工程就是隐患。所以选型时请确认模型上下文长度; 若模型本身较小,可在 Ollama 里把 num_ctx 调到 32768 以上再使用。
四、在上位机接入
- 打开 Lua / 梯形图 / DDC / DTU 任一编辑器,面板右侧点 ⚙ 打开模型管理。
- + 添加供应商,类型选 Ollama(本机)。
- 名称随便填(如「我的本机 Ollama」);Base URL 填
http://127.0.0.1:11434。 - 点 从设备拉取清单——会自动列出已装的模型(如
qwen2.5-coder:7b)。 - 选模型,点 保存。
- 面板底部下拉切到这个供应商与模型,
Enter发送即可。
想给局域网别的机器共用同一台 Ollama,可设 OLLAMA_HOST=0.0.0.0 环境变量后重启服务。
五、实战示例
例 1 · 电机启保停(Lua)
「写一个电机启保停,X0 启动 X1 停止,Y0 输出」→ 面板生成 Lua:
lua
local run = plc.read("X0")
local stop = plc.read("X1")
if run or plc.read("Y0") then
  plc.write("Y0", stop and 0 or 1)
end
点 插入 直接落到当前光标处。各编辑器的回填细节见 10.4 Lua 脚本编辑器里的 AI 使用。
例 2 · 读寄存器置位(Lua)
「读取 D500 的值,当大于 100 时置位 M10」:
lua
local v = plc.read("D500")
if v > 100 then
  plc.write("M10", 1)
else
  plc.write("M10", 0)
end
例 3 · 梯形图(本机或云端都行)
「做一个电机启保停梯形图,X0 启动 X1 停止,Y0 输出」→ 返回 IL:
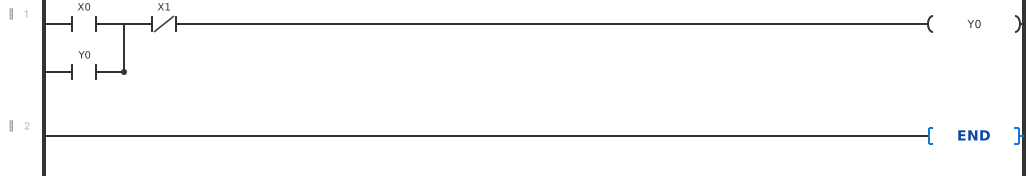
LD    X0
OR    Y0
ANI   X1
OUT   Y0
END
回填方式见 10.5 梯形图编辑器里的 AI 使用。
六、模型选择速查
| 模型 | 体量 | 显存/内存 | 何时选 |
|---|---|---|---|
qwen2.5-coder:3b | ~2GB | 8GB 内存即可 | 机器弱、只要能跑通 |
qwen2.5-coder:7b | ~4.7GB | 16GB 内存 / 6GB 显存 | 默认推荐,效果够用 |
codellama:7b | ~3.8GB | 同 7B | 想要 Llama 系 |
deepseek-coder:6.7b | ~4GB | 同 7B | 想要 DeepSeek 系 |
七、常见问题
Q:Ollama 起不来 / 拉清单为空? 看系统托盘羊驼图标在不在;ollama list 能否列出。服务没启动时点发送会连不上。
Q:生成很慢? 7B 在纯 CPU 上每轮可能 30 秒~几分钟。有 N 卡会自动用 GPU;或改用 10.3 云端模型。
Q:回复是空的 / 乱编函数? 几乎都是上下文 < 32K 被截断(见 第三节),或用了「思考型」模型但输出上限太小。
Q:局域网其它机器连不上本机 Ollama? 设 OLLAMA_HOST=0.0.0.0 并重启 Ollama 服务;注意防火墙放行 11434 端口。